Wynik ma identyfikować osobę, nie tylko pasujący tekst
Pracownik wpisuje fragment nazwiska i widzi kilka podobnych rekordów. Największym ryzykiem nie musi być brak wyniku, lecz wybranie niewłaściwego klienta. Wyszukiwarka CRM powinna zatem pomagać w rozróżnieniu trafień przez dozwolony kontekst: firmę, miejscowość, końcówkę identyfikatora lub opiekuna. Nie pokazuj całej historii kontaktu tylko po to, aby wypełnić listę. Ustal minimalny zestaw informacji wystarczający do świadomego wyboru.
W przykładowej bazie dwie osoby mogą mieć takie samo imię i nazwisko, a jedna firma kilka oddziałów. Nazwa nie jest stabilnym kluczem. Nawet bardzo trafne dopasowanie tekstowe powinno prowadzić do konkretnego identyfikatora rekordu. Przy działaniach o większym skutku, na przykład wysłaniu dokumentu, pokaż ponowne potwierdzenie odbiorcy. Wyszukiwarka skraca drogę do danych, ale nie może przejmować odpowiedzialności za decyzję, którą podpowiedź zaakceptować.
Rozdziel pola dokładne od językowych
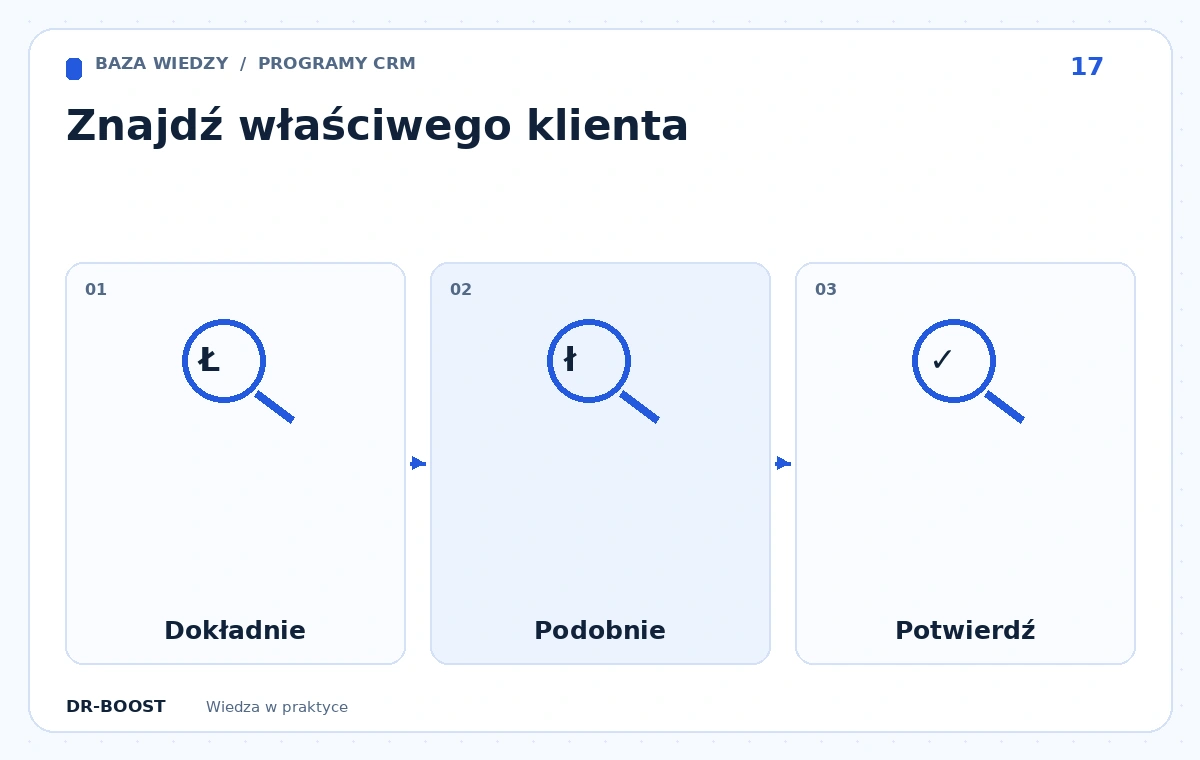
Numer sprawy, identyfikator klienta i pełny adres e-mail warto wyszukiwać inaczej niż nazwisko wpisane z literówką. Dopasowanie przybliżone identyfikatora może zwrócić inny, całkowicie prawidłowy rekord. Dlatego zdefiniuj kolejność: najpierw rozpoznane trafienia dokładne, dopiero później sugestie podobnych nazw. Oznacz różnicę w interfejsie. Użytkownik powinien wiedzieć, czy system znalazł wskazany numer, czy tylko coś do niego podobnego.
Zapisz reguły normalizacji każdego pola. Usunięcie spacji z telefonu może ułatwiać porównanie, ale bezmyślne kasowanie znaków w nazwie organizacji może zlać odrębne podmioty. Zachowaj oryginalną wartość do prezentacji. Indeks pomocniczy nie powinien zastępować danych źródłowych. W testach uwzględnij myślniki, apostrofy, nazwiska dwuczłonowe i nazwy zawierające cyfry. Nie projektuj reguł wyłącznie na podstawie kilku krótkich przykładów z wersji demonstracyjnej.
Polskie znaki wymagają świadomego modelu porównania
Użytkownik może wpisać „Lodz” zamiast „Łódź”. Pomocnicza reprezentacja bez znaków diakrytycznych może zwiększyć wygodę, ale nie wszystkie znaki i języki mają identyczne mapowanie. Sprawdź zachowanie używanej biblioteki i bazy, zamiast zakładać, że prosta funkcja rozwiąże każdy przypadek. Oryginalna pisownia musi pozostać widoczna w wynikach, dokumentach i edycji. Wyszukiwanie uproszczone jest dodatkową drogą odnalezienia rekordu, nie korektą nazwiska.
Dopasowanie trigramowe porównuje fragmenty tekstu i może pomagać przy literówkach, lecz jego wynik nie jest dowodem tożsamości. Próg podobieństwa dobierz do długości zapytania oraz rodzaju danych. Dwa znaki dają znacznie mniej informacji niż pełna nazwa. Przy bardzo krótkich hasłach lepiej poprosić o doprecyzowanie niż pokazać setki pozornie trafnych propozycji. W każdej grupie wyników utrzymuj przewidywalną kolejność i jasne wyróżnienie fragmentu dopasowania.
Uprawnienia obowiązują przed wyświetleniem podpowiedzi
Wyszukiwarka nie może ujawniać istnienia klientów, do których pracownik nie ma dostępu, poprzez liczbę trafień, podpowiedzi lub fragmenty notatek. Filtry organizacji i zakresu uprawnień powinny być częścią właściwego zapytania. Ukrycie rekordu dopiero po kliknięciu jest za późne, jeśli lista zdążyła pokazać nazwisko i szczegóły. Dotyczy to również osobnego silnika indeksującego: musi on otrzymywać aktualne reguły dostępu albo działać w bezpiecznie ograniczonym zakresie.
Cache wyników powinien uwzględniać użytkownika lub poprawnie zdefiniowany segment uprawnień. Wspólna pamięć dla identycznego hasła może przypadkowo pokazać wynik z innego zespołu. Po zmianie właściciela rekordu zadbaj o aktualizację indeksu i ponowną autoryzację przy otwarciu. Nie przechowuj pełnych zapytań zawierających dane klientów w publicznych narzędziach analitycznych. Do poprawiania jakości często wystarczą zagregowane informacje o braku wyników i rodzaju wyszukiwanego pola.
Mierz jakość na konkretnych zadaniach zespołu
Przygotuj zestaw przykładowych zapytań z oczekiwanym rekordem: pełna nazwa, skrót, literówka, brak polskiego znaku i identyfikator. Dane do testów powinny być syntetyczne albo odpowiednio przygotowane, nie przypadkowo skopiowane do publicznego repozytorium. Oceń, czy właściwy wynik pojawia się wysoko, ile propozycji myli odbiorcę i jak często system nie znajduje niczego. Sama szybkość odpowiedzi nie oznacza użyteczności, jeśli lista prowadzi do błędnych wyborów.
Rozdziel wyszukiwanie od łączenia duplikatów. Dwie podobne nazwy mogą oznaczać odrębnych klientów, a dwie różne nazwy ten sam podmiot po zmianie danych. Sugestia podobieństwa jest wskazówką do weryfikacji, nie poleceniem automatycznego scalenia historii. W panelu podpowiedzi warto pokazać powód trafienia, na przykład zgodny numer sprawy lub podobne nazwisko. To zwiększa zrozumienie działania bez zdradzania poufnych pól i skomplikowanego wyniku matematycznego.
Szybkość poprawiaj dopiero przy zachowaniu trafności
Ogranicz liczbę wyników, opóźnij wysłanie zapytania podczas szybkiego pisania i anuluj nieaktualne odpowiedzi w interfejsie. Stara odpowiedź nie powinna zastąpić nowszego wyniku tylko dlatego, że dotarła później. Po stronie bazy sprawdź plan zapytania i indeksy odpowiednie dla wybranego porównania. Nie stosuj kosztownego dopasowania przybliżonego do każdej kolumny, jeśli zadanie można rozstrzygnąć po jednym identyfikatorze.
Odbiór zakończ próbą na telefonie i z klawiaturą: widoczny wybór, czytelne etykiety, możliwość zamknięcia podpowiedzi i brak przeskakiwania fokusu. Sprawdź również brak połączenia oraz pusty wynik. Dobra wyszukiwarka wyjaśnia, jak doprecyzować zapytanie, zamiast oskarżać użytkownika o błąd. W CRM najważniejsze jest szybkie odnalezienie właściwej sprawy z zachowaniem granic dostępu, nie maksymalna liczba rekordów pasujących do dowolnego fragmentu tekstu.